La mayoría de las herramientas de prevención y detección de fraude entregan sus resultados mediante puntuaciones de fraude. Pero ¿qué miden y cómo funcionan exactamente?
En este artículo explicamos los fundamentos de la puntuación de fraude y cómo aprovecharla para mejorar la eficiencia de su negocio.
¿Qué es un score de fraude?
Un score de fraude es un número que responde a la pregunta: “¿Qué probabilidad hay de que esta persona sea un defraudador?”. El fraud scoring asigna un valor al nivel de riesgo de una acción del usuario. El score se calcula mediante reglas que suman o restan puntos según los datos conocidos sobre esa persona.
Por ejemplo, la acción puede ser un registro, un inicio de sesión o un pago con tarjeta. Los datos conocidos incluyen el tipo de conexión, la dirección de correo electrónico o la configuración del dispositivo. De hecho, cada uno de estos elementos contiene decenas de datos distintos. Una dirección de correo puede aparecer en listas negras conocidas, por ejemplo. O el origen de la conexión puede estar vinculado a nodos Tor conocidos o a ubicaciones sospechosas.
¿Cómo funciona el score de fraude?
El score de fraude es el resultado de evaluar el riesgo de una acción del usuario a partir de los datos disponibles y de reglas predefinidas. Igual que un buró de crédito calcula un score crediticio, un software de prevención de fraude calcula un score de riesgo analizando señales vinculadas al comportamiento y la identidad del usuario. Según el resultado, la acción puede aprobarse, rechazarse o enviarse a revisión manual de forma automática.
Así funciona en la práctica:
- Un usuario intenta realizar una acción (registro, inicio de sesión o pago).
- El sistema recopila datos de los campos enviados y de señales técnicas (por ejemplo, tipo de dispositivo o metadatos de red).
- Un proceso de enriquecimiento de datos amplía esta información mediante el análisis de la huella digital y fuentes externas para revelar patrones y marcadores de riesgo.
- Todos los datos pasan por el motor de scoring, donde las reglas asignan valores ponderados a cada señal.
- Se calcula el score de fraude final.
- El sistema activa una acción: aprobar, rechazar o enviar a revisión manual.
Ejemplo de cálculo de un score de fraude
Imagine que un usuario intenta completar un pago. Mientras se procesa la transacción, el motor de scoring evalúa una serie de señales de riesgo.
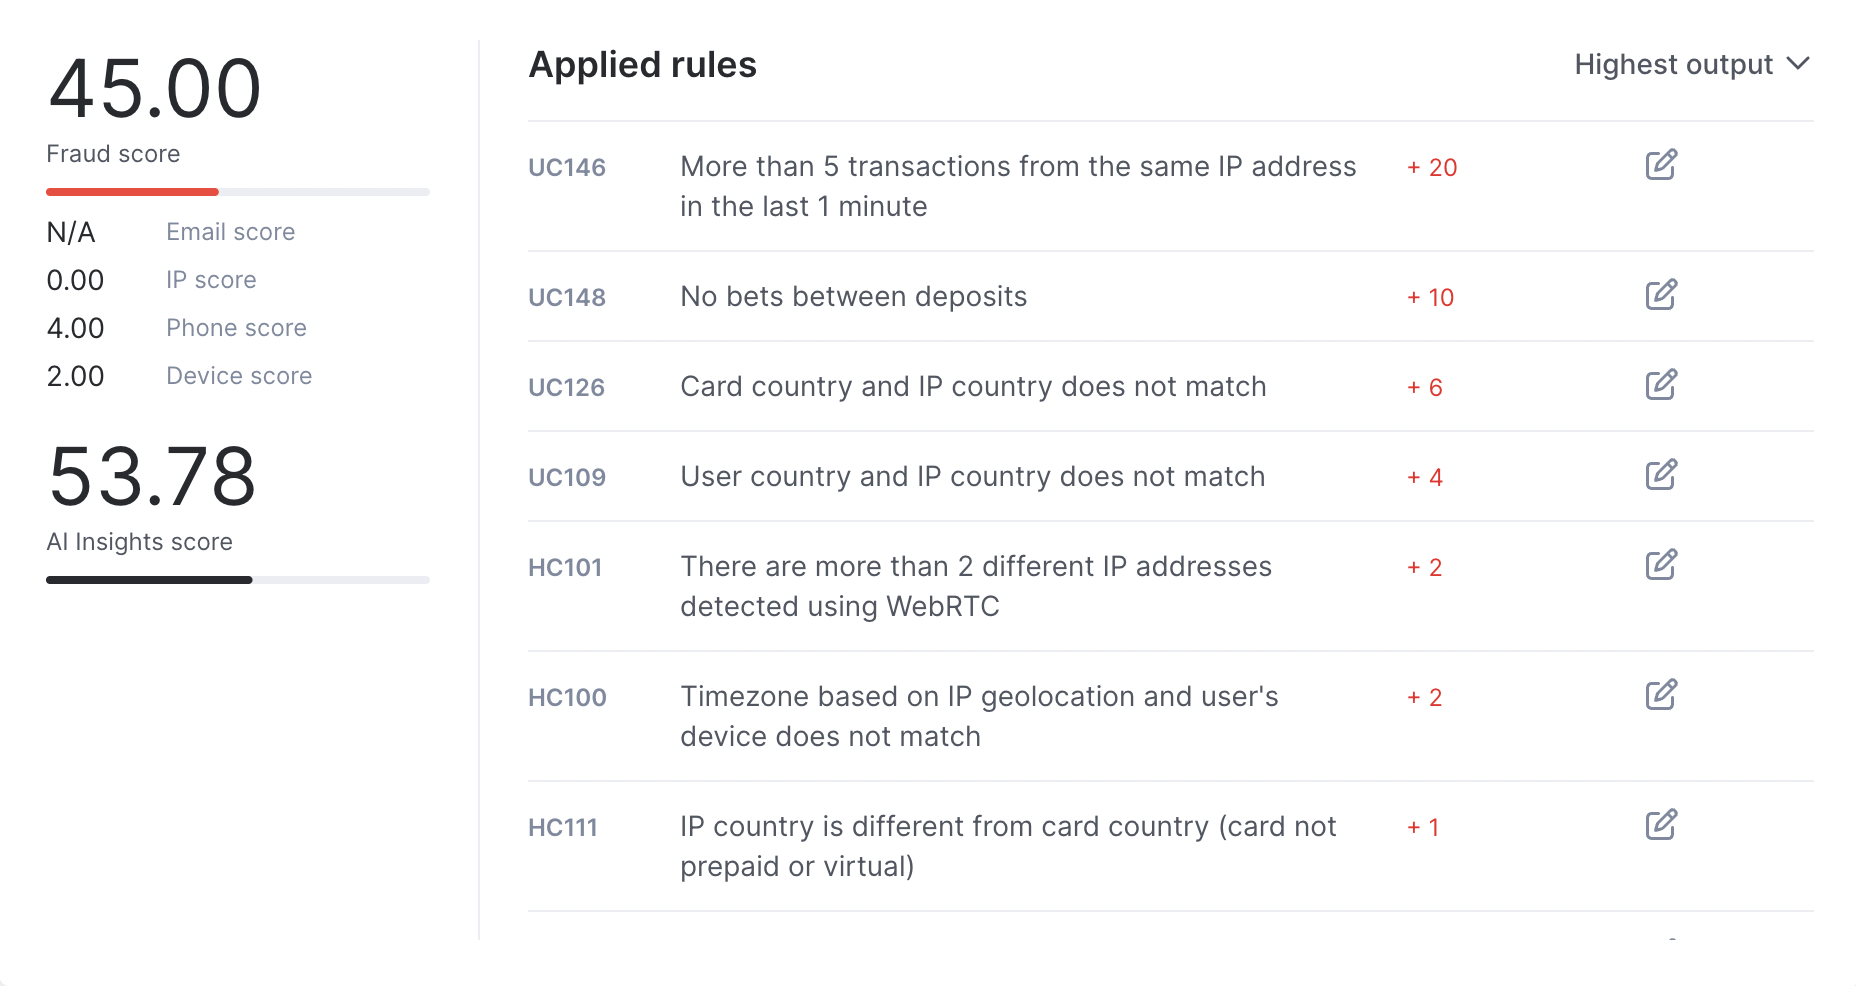
En este caso se detectan varias: el usuario activa reglas relacionadas con el correo electrónico y la identidad, tiene una huella digital limitada y muestra patrones de comportamiento inusuales. Además, se marca riesgo adicional por el uso de un dominio de correo gratuito y una conexión sospechosa desde un centro de datos, ambos habituales en la actividad automatizada.
En conjunto, estos factores dan como resultado un score de fraude de 76 sobre 100, lo que indica una transacción de alto riesgo. Según la lógica de su negocio, esto podría activar un rechazo automático o una revisión manual.
Ventajas del score de fraude
Para entender sus beneficios, imagine que tiene una pequeña tienda en línea y quiere reducir el fraude transaccional (cuando los usuarios pagan con datos de tarjetas robadas).
Su objetivo es reducir los contracargos, identificar a los usuarios legítimos, filtrar a los defraudadores y facilitar los pagos válidos. ¿Qué puede hacer el score de fraude por usted? Estas son sus principales ventajas:
- Automatización: en lugar de revisar manualmente cada compra, el sistema asigna un valor a cada acción y la aprueba o rechaza según el resultado. También puede revisar las transacciones cuyo resultado no sea concluyente.
- Escalabilidad: el score de fraude permite a su tienda procesar muchas más transacciones con mayor rapidez. Así puede centrarse en hacer crecer su negocio con tranquilidad, mientras la gestión del riesgo se realiza en segundo plano.
- Autenticación dinámica: aunque el resultado indique la necesidad de una revisión manual, puede añadir otra capa de seguridad mediante activadores. Si alguien se registra en su plataforma pero los datos de sus transacciones sugieren que podría ser un usuario de riesgo, su sistema puede activar una autenticación adicional, como la 2FA, para confirmar su identidad y disuadir a posibles defraudadores.
- Menos fricción y menor abandono de clientes: al automatizar las revisiones con un score de riesgo, el recorrido del cliente es más fluido. Por ejemplo, Amazon no solicita el CVV de la tarjeta para agilizar el pago. Puede reducir los pasos entre el usuario y su pago, siempre que solo se revise el comportamiento de riesgo.
- Mayor flexibilidad: ajustar los valores usted mismo le permite decidir cómo mitigar el riesgo. Puede hacerlo según la temporada o para artículos concretos, como productos de alto valor o descargas digitales de bajo valor. Tenga en cuenta que no todas las herramientas de prevención de fraude permiten ajustar los umbrales.
Desventajas del score de fraude
La mayor desventaja es que no existen dos empresas que usen los mismos criterios, por lo que cambiar de proveedor suele implicar volver a aprender a evaluar el riesgo. Por ejemplo, un puntaje de 0 puede indicar un usuario excelente para un proveedor y uno de riesgo para otro. En SEON ofrecemos umbrales predefinidos para ayudarle a empezar, y puede personalizarlos fácilmente en cualquier momento.
- 0 a 10: La acción es segura y puede aprobarse automáticamente.
- 10 a 20: La acción podría ser de riesgo y conviene revisarla manualmente. El flujo del usuario se pausa momentáneamente y puede crear una alerta (por ejemplo, por correo electrónico) para procesar la acción de forma manual. Otra opción es activar automáticamente una segunda serie de verificaciones en esta fase. Esta estrategia de fricción dinámica le ayudará a reducir los falsos positivos.
- 20 o más: La acción es de riesgo y se rechazará. Si lo desea, puede incluir de forma permanente los datos del usuario en una lista negra.
Todos estos valores pueden ajustarse manualmente. Pero antes de modificarlos, es importante entender bien qué reglas generan el score de fraude.
Cómo funciona la implementación del score de fraude
Implementar el score de fraude de forma eficaz va más allá de activar una función: requiere una estrategia basada en la transparencia, la adaptabilidad y la calidad de los datos. Este marco le ayudará a empezar con buen pie.
1. Conozca el origen de sus reglas de fraude
El score de fraude se calcula mediante conjuntos de reglas por capas, que pueden proceder de tres fuentes:
- Reglas sectoriales predefinidas, seleccionadas por especialistas en fraude para abordar amenazas comunes.
- Reglas personalizadas, adaptadas a su modelo de negocio, su tolerancia al riesgo o sus categorías de producto.
- Reglas generadas por machine learning, basadas en tendencias históricas y patrones de comportamiento.
Como el riesgo de fraude varía según el sector, una regla eficaz en un ámbito puede generar falsos positivos en otro. Por eso es fundamental probar las reglas con datos históricos reales de su entorno y asegurarse de que cualquier lógica sugerida por el sistema sea explicable y tenga un puntaje de confianza.
2. Aproveche lo mejor de ambos modelos: whitebox y blackbox
Las estrategias de prevención de fraude más sólidas combinan dos enfoques distintos:
- Scoring whitebox (caja blanca): ofrece a su equipo de fraude visibilidad y control totales sobre las reglas, la lógica y los umbrales.
- Scoring blackbox (caja negra): impulsado por nuestro motor de machine learning en entrenamiento constante, detecta patrones difíciles de identificar y nuevas tendencias de fraude a partir de un conjunto de datos global. Es ideal para anticiparse.
Juntos, estos sistemas ofrecen un marco de evaluación del riesgo equilibrado y dinámico. Las organizaciones pueden actuar con cada score por separado o combinarlos para crear reglas y umbrales compuestos.
3. Pruebe y ajuste con datos de contexto
El score de fraude solo es tan preciso como la calidad de los datos que analiza. Una buena implementación debe priorizar lo siguiente:
- Señales en tiempo real: análisis de la huella digital, inteligencia de dispositivos y señales de comportamiento para generar contexto sin aumentar la fricción.
- Validación cruzada: comprobación de datos clave como la IP, el correo electrónico o el dispositivo frente a marcadores de riesgo conocidos, como proxies, cuentas desechables o comportamiento de bots.
- Precisión sin fricción: equilibrio entre la detección de fraude y una experiencia de usuario fluida, sobre todo en el onboarding o el pago.
Busque sistemas que le permitan ver cómo habrían funcionado las nuevas reglas con datos históricos antes de activarlas. Es una salvaguarda que ayuda a reducir los falsos positivos y a perfeccionar su lógica de scoring con el tiempo.
¿Cómo funciona el score de fraude en SEON?
El score de fraude de SEON es transparente y totalmente personalizable. Combina reglas definidas por personas con modelos de machine learning whitebox y blackbox. Diseñado para adaptarse a una gran variedad de sectores y estrategias de riesgo, permite definir reglas propias y, a la vez, ofrece automatización inteligente para quienes prefieren delegar la gestión.
Desde el panel de administración, en el motor de scoring, se pueden ver, editar o añadir reglas, además de acceder a información generada por machine learning a partir de datos históricos para optimizar la detección de fraude.
1. Reglas predeterminadas
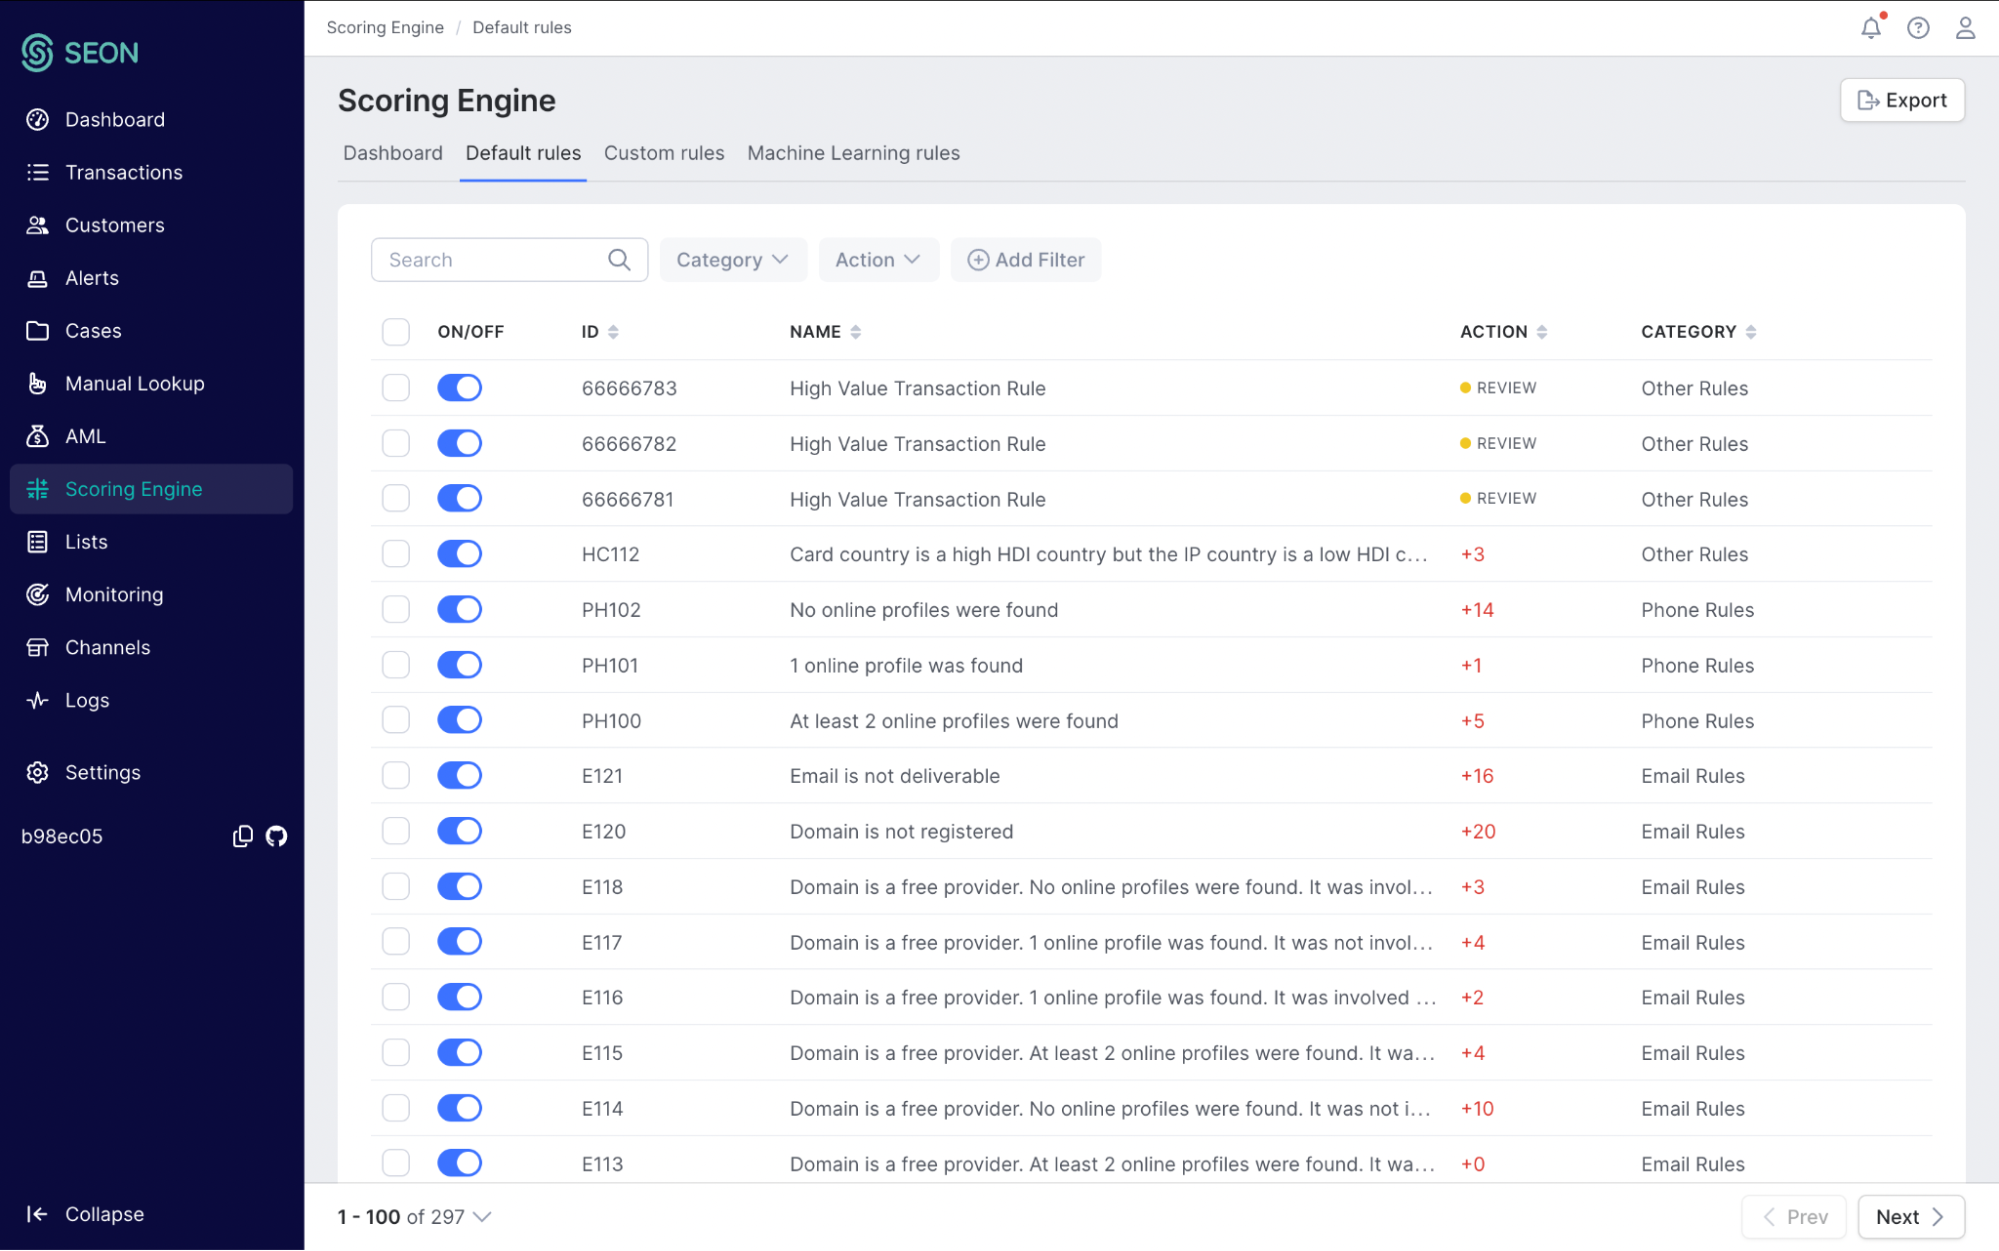
Las reglas predeterminadas son las recomendaciones base de SEON, agrupadas por categoría, como correo electrónico, conexión técnica y teléfono.
Por ejemplo, una regla puede sumar +10 puntos al score si se usa un número de teléfono desechable. En cambio, detectar un protocolo de acceso remoto puede sumar solo +1 punto. Esto se debe a que, de forma aislada, no es una señal de fraude fuerte, pero combinada con otras alertas ayuda a crear un perfil de riesgo muy preciso.
2. Reglas personalizadas
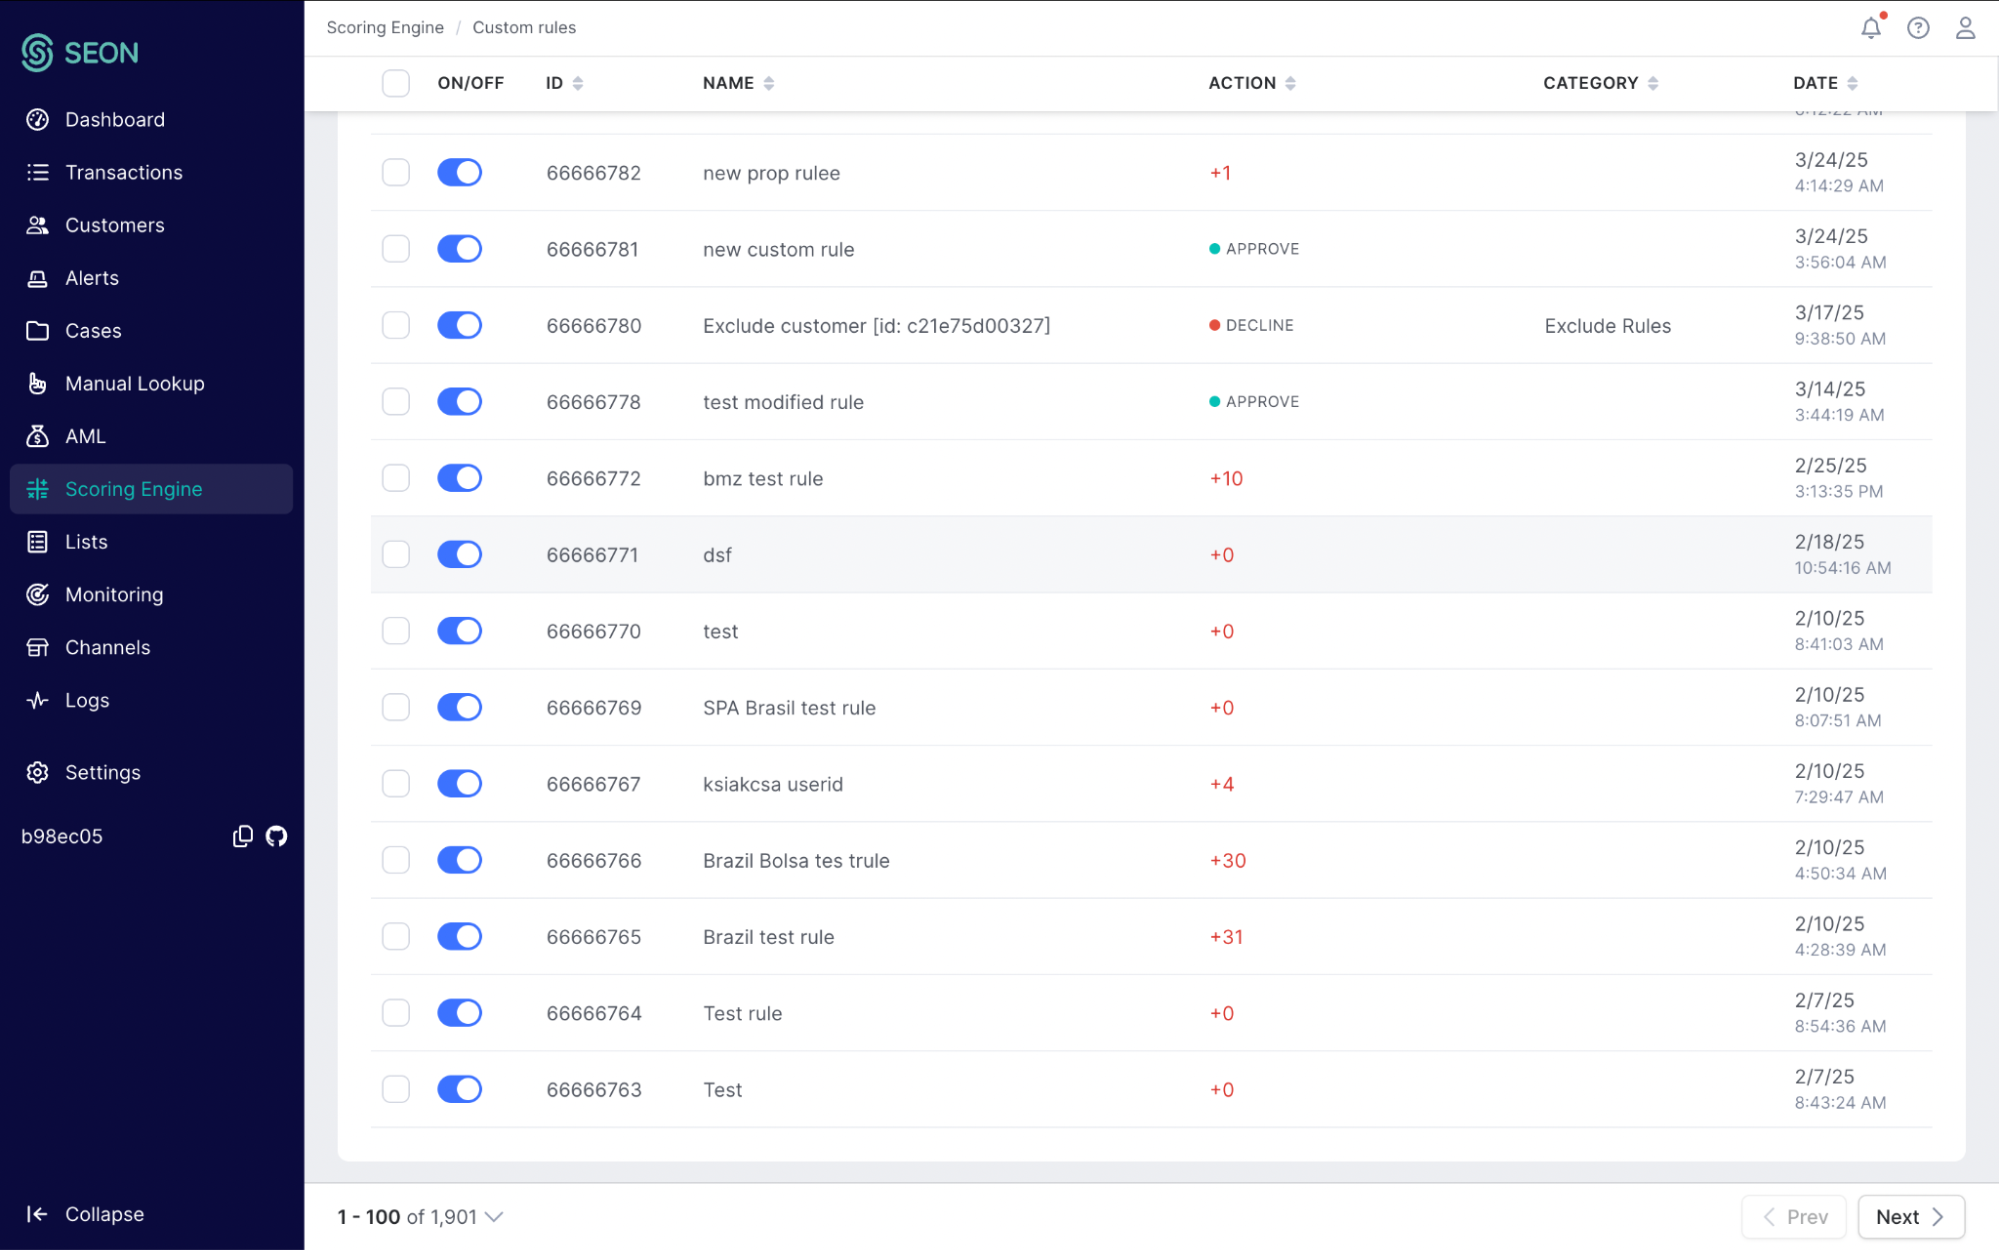
Las reglas personalizadas dan a los usuarios de SEON control total sobre el score de fraude, ya que les permiten definir una lógica adaptada a su tolerancia al riesgo, su sector y sus flujos de trabajo. Cada regla puede activar acciones concretas con precisión decimal: ajustar el score, cambiar el estado de la transacción (aprobar, revisar, rechazar) o gestionar listas de usuarios.
Las reglas se crean con uno o varios de estos tipos de parámetros:
- Coincidencia de datos: busca coincidencias exactas de valores (por ejemplo, marcar dispositivos con la batería al 0 %).
- Comparación: utiliza operadores estándar como “mayor que”, “existe” o “igual a” (por ejemplo, restar puntos a usuarios con varios perfiles en redes sociales).
- Velocidad: analiza el comportamiento a lo largo del tiempo (por ejemplo, bloquear marcadores de conexión usados por más de 15 usuarios en 30 minutos).
Se pueden combinar varias condiciones, agrupar reglas en categorías personalizadas y usar plantillas para agilizar la configuración. Todas las reglas pueden buscarse y probarse con datos históricos mediante una función de vista previa integrada.
3. Modelos de IA y machine learning
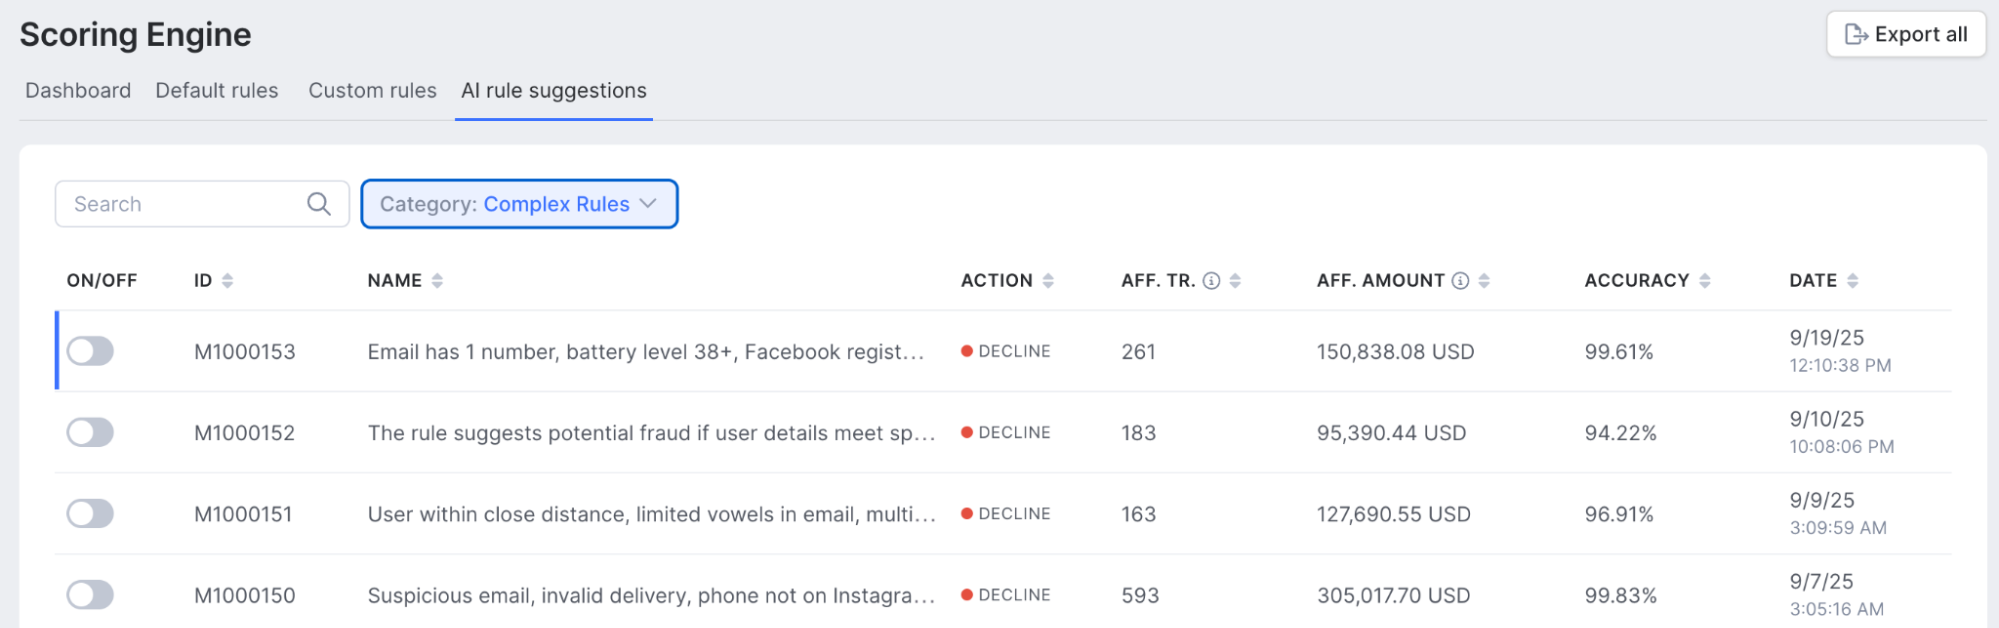
Los modelos de IA y machine learning generan sugerencias de reglas a partir de patrones identificados en datos históricos y decisiones etiquetadas. Estas reglas son totalmente transparentes: cada recomendación muestra su lógica y un puntaje de precisión asociado, lo que facilita entender el razonamiento detrás de cada una.
Con el tiempo, el modelo se perfecciona aprendiendo de los resultados de aprobación, revisión y rechazo. Las reglas sugeridas pueden revisarse, ajustarse o implementarse directamente en el motor de scoring. Para los equipos que buscan más automatización, estas reglas generadas con IA pueden activarse automáticamente según umbrales de confianza.
4. Configuraciones predefinidas por sector
Además del scoring whitebox, la plataforma ofrece un potente módulo de machine learning blackbox que evalúa de forma independiente la probabilidad de fraude. Este sistema funciona en segundo plano e identifica patrones sutiles y tácticas de fraude en evolución.
Una vez activado, el scoring blackbox asigna a cada transacción un score de riesgo independiente (de 0 a 100), basado en los datos globales de fraude de SEON y en las tendencias específicas de cada cliente. El score blackbox también puede incorporarse a reglas personalizadas, por ejemplo, para marcar automáticamente las transacciones con un score blackbox superior a 30 y mejorar la automatización de decisiones.
Ejemplo de flujo de score de fraude
El motor de scoring de SEON analiza cientos de datos mediante la evaluación de la huella digital y la inteligencia de dispositivos para ofrecer evaluaciones de riesgo precisas y en tiempo real. Así funciona el proceso en la práctica:
- El usuario se registra: se da de alta en su plataforma con solo un nombre y una dirección de correo electrónico.
- Comienza el enriquecimiento automático: en segundo plano, SEON recopila datos mediante el análisis de la huella digital y del dispositivo, y obtiene información como la dirección IP, el tipo de dispositivo, la versión del navegador y las redes sociales vinculadas al correo o al número de teléfono.
- Contraste con datos externos: estos datos se enriquecen con fuentes externas para revelar información como la calidad del dominio del correo, su presencia en listas negras o su historial de uso en otras plataformas.
- Activación del motor de scoring: el conjunto de datos enriquecido pasa por los motores de scoring basados en reglas y en machine learning.
- Resultado del score de riesgo: se obtiene un score de fraude que ayuda a decidir si el usuario debe aprobarse, revisarse o bloquearse.
Omitir los pasos de enriquecimiento limitaría la visibilidad sobre la huella digital del usuario, debilitaría la eficacia de su evaluación de riesgo de clientes y podría dejar pasar comportamientos fraudulentos.
Conclusión
Un score de fraude eficaz es la base de la gestión de riesgos moderna. Al combinar reglas transparentes con machine learning adaptativo, las empresas pueden automatizar decisiones complejas sin sacrificar precisión. Este enfoque de protección por capas garantiza una experiencia sin fricción para los usuarios legítimos y, al mismo tiempo, detecta con precisión el comportamiento de alto riesgo. En definitiva, un motor de scoring personalizable ofrece la agilidad y la precisión necesarias para anticiparse a la evolución del fraude.
Traducido y revisado por el equipo hispanohablante de SEON.
Preguntas frecuentes
¿Cómo se calcula un score de fraude?
El score de fraude se calcula procesando los datos del usuario mediante reglas de riesgo. El puntaje total debe situarse dentro de un rango que le indique si debe aceptar, rechazar o revisar la acción.
¿Más reglas implican más tiempo de carga?
Depende. En general, las reglas largas sobrecargan más el sistema que un mayor número de reglas. Es decir, las reglas extensas con más parámetros afectan más al rendimiento que las reglas cortas. A veces, la solución es dividirlas en reglas más cortas y sencillas. El equipo de Customer Success de SEON, formado exclusivamente por gestores y analistas de fraude, puede ayudarle a identificar estas reglas y optimizarlas para agilizar sus operaciones.
¿Es confiable el score de fraude?
El score de fraude puede ofrecer resultados con una precisión muy alta. Sin embargo, la calidad de los resultados depende del tipo de reglas aplicadas, de lo actualizadas que estén e incluso del sector en el que opere.